Hiếm có chủ đề nào trong ngành phần mềm được bàn luận nhiều như ứng dụng AI trong phát triển phần mềm. Một bên tin rằng chỉ vài năm nữa AI sẽ tự viết phần lớn phần mềm, kỹ sư phần mềm sẽ thất nghiệp hàng loạt và doanh nghiệp phần mềm chỉ còn là “người vận hành prompt”. Bên còn lại xem AI như một trào lưu, code do AI sinh ra thiếu tin cậy, và cách an toàn nhất là chờ thêm hoặc cấm hẳn.
Cả hai cách nhìn đều có phần đúng, nhưng giống câu chuyện thầy bói xem voi: mỗi người chạm vào một bộ phận rồi khẳng định đó là toàn bộ con voi. Với CIO, CTO hay CEO, cái giá của một góc nhìn phiến diện rất cụ thể: hoặc cắt giảm nhân sự sai thời điểm và phá vỡ năng lực lõi, hoặc chậm chân trong khi đối thủ đã tái cấu trúc cách làm phần mềm, hoặc tệ hơn, để AI được dùng tràn lan ngoài tầm kiểm soát.
Thực tế, câu hỏi đặt ra cho lãnh đạo không còn là có nên ứng dụng AI hay không, mà là ứng dụng như thế nào để vừa tạo ra giá trị, vừa giữ được độ tin cậy, an ninh và an toàn thông tin của hệ thống. Bài viết này tổng hợp các nghiên cứu đáng tin cậy hiện có để ghép lại bức tranh đầy đủ, phân tích vì sao các hệ thống lõi của doanh nghiệp đòi hỏi cách tiếp cận khác hẳn phần mềm quy mô nhỏ, và đề xuất một khung ứng dụng AI có kiểm soát trong phát triển phần mềm.
Hai góc nhìn phiến diện về AI trong phát triển phần mềm
Góc nhìn lạc quan ngây thơ thường xuất phát từ những bản demo ấn tượng: một agent dựng xong ứng dụng CRUD trong vài phút, một prompt sinh ra hàng trăm dòng code chạy được. Từ đó suy ra năng suất sẽ tăng gấp nhiều lần và đội ngũ kỹ sư có thể thu nhỏ tương ứng. Điểm mù của góc nhìn này là nhầm lẫn giữa tốc độ gõ code và tốc độ tạo ra phần mềm có giá trị, vốn còn phụ thuộc vào hiểu đúng bài toán, kiến trúc, kiểm thử, bảo mật, vận hành và trách nhiệm khi có sự cố.
Góc nhìn e dè thái quá thường dựa trên trải nghiệm thật: AI đưa ra lời giải “gần đúng”, tạo lỗ hổng bảo mật, hoặc làm kỹ sư mất thời gian sửa nhiều hơn tự viết. Điểm mù ở đây là đánh giá AI qua cách dùng chưa trưởng thành rồi kết luận về năng lực của công nghệ, trong khi công cụ và phương pháp đang thay đổi theo từng quý. Nguy hiểm hơn, sự e dè ở cấp lãnh đạo không làm nhân viên ngừng dùng AI, mà chỉ khiến việc sử dụng diễn ra ở nơi doanh nghiệp không nhìn thấy.
Dữ liệu thực tế nói gì?
Để tránh tranh luận bằng cảm tính, hãy nhìn vào các nguồn dữ liệu có phương pháp rõ ràng: khảo sát DORA của Google Cloud, khảo sát nhà phát triển của Stack Overflow, thử nghiệm ngẫu nhiên có đối chứng của METR, nghiên cứu thị trường lao động của Stanford và đánh giá bảo mật code AI của Veracode.
1. AI đã phổ biến, nhưng niềm tin thì chưa
Báo cáo DORA 2025, khảo sát gần 5.000 chuyên gia công nghệ, cho thấy 90% người tham gia đã dùng AI trong công việc và hơn 80% cảm nhận năng suất tăng. Tuy vậy, vẫn có 30% cho biết họ ít hoặc không tin vào code do AI tạo ra.
Stack Overflow Developer Survey 2025 cho kết quả tương tự: 84% người trả lời đang dùng hoặc dự định dùng AI, 51% lập trình viên chuyên nghiệp dùng hằng ngày. Nhưng số người không tin vào độ chính xác của công cụ AI (46%) đã vượt số người tin (33%), và chỉ khoảng 3% “rất tin tưởng”. Phàn nàn phổ biến nhất, được 66% người dùng nêu ra, là lời giải “gần đúng nhưng chưa đúng”, kéo theo việc debug code do AI sinh ra tốn thời gian hơn (45%).
Nói cách khác, AI đã trở thành công cụ hằng ngày của kỹ sư, nhưng là một cộng sự nhanh và hay sai, cần được kiểm chứng chứ không phải một “nhà tiên tri”.
2. Cảm nhận nhanh hơn chưa chắc đã nhanh hơn
Thử nghiệm ngẫu nhiên có đối chứng của METR năm 2025 với 16 lập trình viên mã nguồn mở giàu kinh nghiệm, trên 246 tác vụ thực tế, cho kết quả gây bất ngờ: khi được dùng AI, thời gian hoàn thành tăng 19%. Điều đáng chú ý hơn là trước thử nghiệm, họ dự đoán AI giúp nhanh hơn 24%, và ngay cả sau khi đã chậm đi, họ vẫn tin mình nhanh hơn khoảng 20%.
Kết quả này không có nghĩa AI vô dụng. Bản cập nhật đầu năm 2026 của METR cho thấy với công cụ mới hơn, lập trình viên nhiều khả năng đã được tăng tốc, dù chính nhóm nghiên cứu thừa nhận hiệu ứng chọn mẫu khiến con số chính xác còn khó xác định. Bài học cho lãnh đạo nằm ở chỗ khác: cảm nhận của đội ngũ không phải là thước đo năng suất. Quyết định đầu tư hay cắt giảm nhân sự dựa trên cảm nhận là đặt cược mù.
3. AI là bộ khuếch đại, không phải liều thuốc
Kết luận trung tâm của DORA 2025 là AI đóng vai trò bộ khuếch đại: tổ chức có nền tảng kỹ thuật và quy trình tốt sẽ tốt hơn, tổ chức đang có vấn đề sẽ thấy vấn đề lộ rõ và trầm trọng hơn. Việc ứng dụng AI tương quan thuận với thông lượng phát hành phần mềm, nhưng vẫn tương quan nghịch với độ ổn định, tức là nhiều thay đổi hơn đi kèm nhiều lỗi khi phát hành và nhiều việc làm lại hơn.
DORA cũng đề xuất mô hình bảy năng lực giúp khuếch đại tác động tích cực của AI: quan điểm và chính sách AI rõ ràng; hệ sinh thái dữ liệu lành mạnh; dữ liệu nội bộ sẵn sàng cho AI; quản lý phiên bản chặt chẽ; làm việc theo lô nhỏ; tập trung vào người dùng; và nền tảng nội bộ chất lượng. Đáng chú ý, gần như tất cả đều là năng lực kỹ thuật phần mềm cơ bản, không gắn với một công cụ AI cụ thể nào.
4. Không có làn sóng thất nghiệp hàng loạt, nhưng cửa vào nghề đang hẹp lại
Nghiên cứu “Canaries in the Coal Mine?” của Stanford Digital Economy Lab, dựa trên dữ liệu bảng lương quy mô lớn tại Mỹ, đưa ra bức tranh hai mặt. Bản cập nhật tháng 8/2026 không tìm thấy bằng chứng về tình trạng mất việc lan rộng trên toàn nền kinh tế. Tuy nhiên, việc làm của nhóm lao động 22 đến 25 tuổi trong các nghề chịu tác động mạnh của AI, trong đó có phát triển phần mềm, hiện thấp hơn 19% so với mức lẽ ra đạt được nếu tăng trưởng ngang nhóm ít chịu tác động. Nhóm lao động có kinh nghiệm không có khoảng chênh tương tự.
Thông điệp không phải là “kỹ sư phần mềm sẽ thất nghiệp”, mà là những công việc dễ hệ thống hóa đang được AI đảm nhận trước, và đó lại chính là loại việc trước đây dùng để đào tạo người mới vào nghề.
5. Code do AI sinh ra chưa an toàn theo mặc định
Báo cáo GenAI Code Security 2025 của Veracode kiểm tra hơn 100 mô hình ngôn ngữ lớn trên 80 tác vụ lập trình và ghi nhận code do AI sinh ra chứa lỗ hổng bảo mật ở 45% trường hợp. Với các lỗi phổ biến như cross-site scripting và log injection, tỷ lệ mô hình không viết được code an toàn lần lượt là 86% và 88%. Đáng lưu ý hơn, năng lực bảo mật gần như không cải thiện theo thời gian dù khả năng sinh code đúng cú pháp ngày càng tốt, và mô hình lớn hơn không an toàn hơn đáng kể so với mô hình nhỏ.
Hàm ý rất rõ: an toàn của code không thể phó mặc cho mô hình. Nó phải được bảo đảm bằng quy trình, công cụ kiểm tra và con người chịu trách nhiệm.
Ghép lại bức tranh: nút thắt dịch chuyển chứ không biến mất
Khi đặt các mảnh dữ liệu cạnh nhau, con voi hiện ra rõ hơn. AI làm cho khâu viết code rẻ và nhanh hơn đáng kể. Nhưng phần mềm có giá trị chưa bao giờ chỉ là code. Khi một khâu tăng tốc mà các khâu còn lại giữ nguyên, công việc sẽ dồn ứ ở phía sau: hàng đợi code review dài hơn, kiểm thử không theo kịp, lỗi “gần đúng” và lỗ hổng bảo mật lọt xuống môi trường production, chi phí vận hành tăng lên.
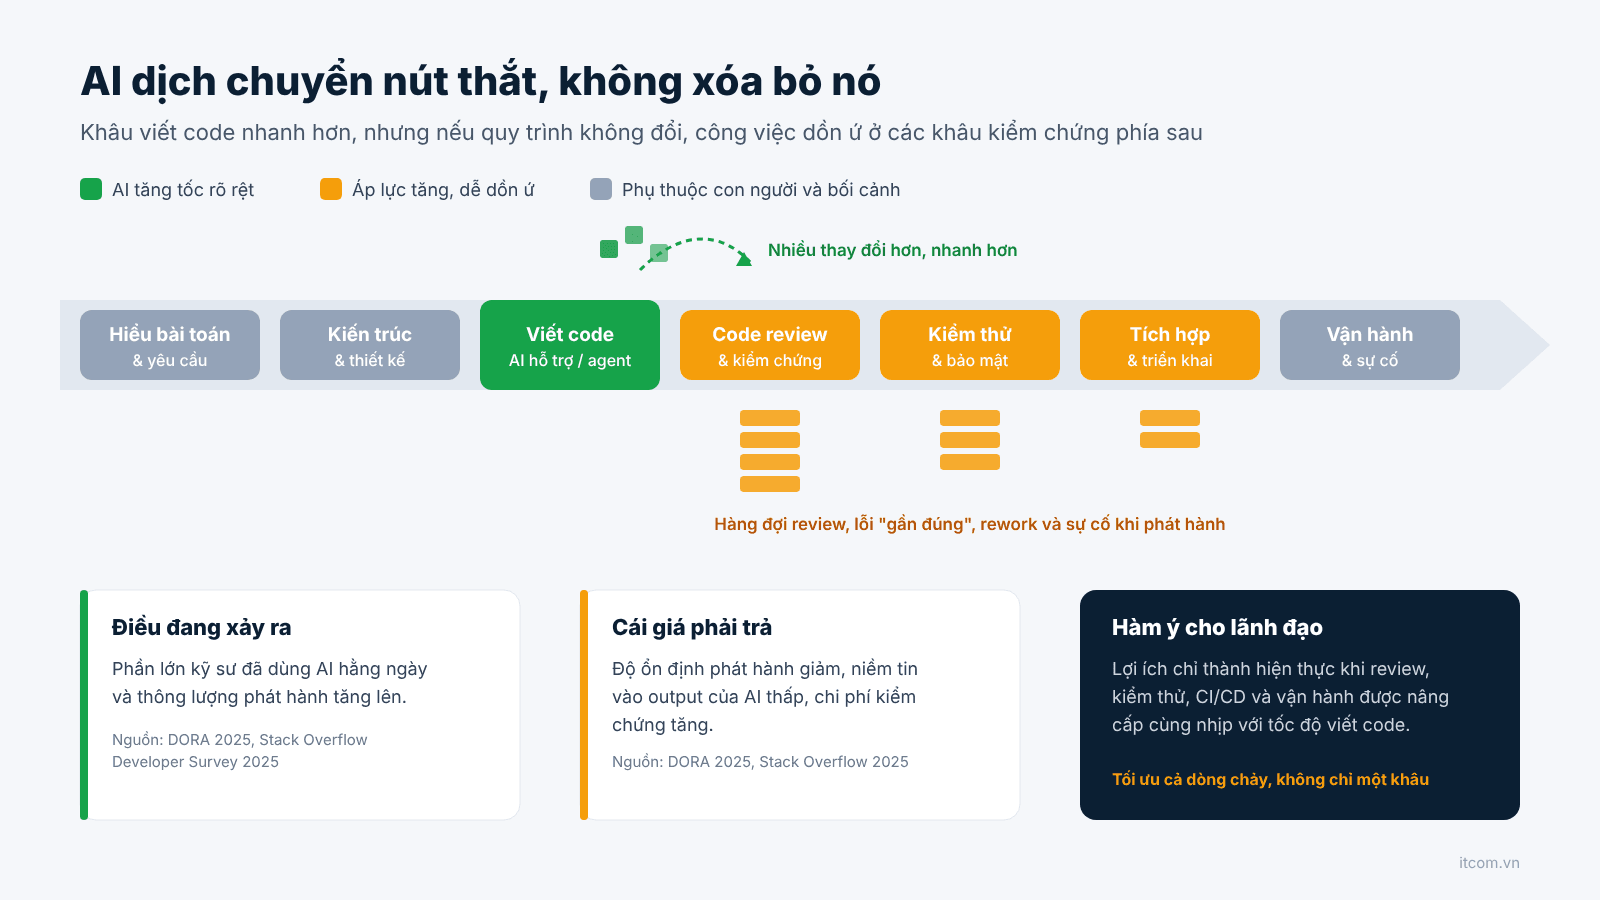
Vì vậy, giá trị cốt lõi của đội ngũ kỹ sư đang dịch chuyển: từ “viết được code” sang hiểu đúng bài toán nghiệp vụ, thiết kế kiến trúc, đặt ra tiêu chí chất lượng, kiểm chứng output của AI, và chịu trách nhiệm cuối cùng với hệ thống. Đây cũng là lý do 75% người trả lời khảo sát Stack Overflow cho rằng ngay cả khi AI làm được phần lớn việc code, họ vẫn sẽ cần hỏi một người khác khi không tin vào câu trả lời của AI.
Phần mềm “viết chơi” và hệ thống lõi doanh nghiệp là hai bài toán khác nhau
Phần lớn những câu chuyện “AI viết xong ứng dụng trong một buổi chiều” đến từ các dự án mới, quy mô nhỏ và ít ràng buộc: một landing page, một công cụ nội bộ, một bản prototype. Ở đó, sai một chút thì sửa lại, và người viết prompt thường cũng là người dùng cuối. Hệ thống quản trị doanh nghiệp lớn, core banking, quản lý hợp đồng bảo hiểm, thanh toán hay chứng khoán thuộc về một thế giới khác, với những đặc điểm khiến việc ứng dụng AI khó hơn nhiều:
- Nghiệp vụ phức tạp và nhiều quy tắc ngầm. Logic tính phí, tính lãi, bồi thường, hạn mức, luồng phê duyệt được tích lũy qua nhiều năm và phần lớn chỉ tồn tại trong codebase, tài liệu nội bộ và kinh nghiệm của đội vận hành. Mô hình AI công cộng chỉ có kiến thức chung, nên lời giải “gần đúng” ở đây có thể chạy được nhưng sai nghiệp vụ.
- Hệ thống kế thừa và tích hợp chằng chịt. Một thay đổi nhỏ có thể ảnh hưởng đến nhiều hệ thống vệ tinh, batch job, báo cáo quản trị và báo cáo gửi cơ quan quản lý.
- Dữ liệu nhạy cảm và nghĩa vụ tuân thủ ngày càng chặt. Tại Việt Nam, Luật Bảo vệ dữ liệu cá nhân có hiệu lực từ 01/01/2026; Luật Trí tuệ nhân tạo được Quốc hội thông qua ngày 10/12/2025 và có hiệu lực từ 01/3/2026, quản lý AI theo mức độ rủi ro và đề cao vai trò giám sát của con người. Ngành ngân hàng còn có quy định riêng về an toàn hệ thống thông tin như Thông tư 09/2020/TT-NHNN.
- Yêu cầu truy vết và kiểm toán. Mỗi thay đổi phải trả lời được ai yêu cầu, ai viết, ai duyệt và đã kiểm thử thế nào. “Do AI viết” không phải câu trả lời được chấp nhận trước kiểm toán viên hay cơ quan quản lý.
- Chi phí sai sót rất lớn. Một lỗi làm tròn trong tính lãi, một lỗ hổng phân quyền hay một sự cố đúng ngày chốt sổ có thể gây thiệt hại tài chính, pháp lý và uy tín vượt xa toàn bộ chi phí dự án.
Vì vậy, với nhóm hệ thống này, ứng dụng AI không thể dừng ở mức “mua công cụ rồi để kỹ sư tự dùng”. Nó đòi hỏi một AI-SDLC, tức vòng đời phát triển phần mềm có tích hợp AI, được thiết kế chặt chẽ ngay từ đầu, với quy chế, tiêu chuẩn, quy trình và kiến trúc triển khai phù hợp với đặc thù của từng doanh nghiệp, từng khách hàng và từng dự án.
Câu hỏi không còn là “có dùng hay không”, mà là “dùng như thế nào”
Một số doanh nghiệp, nhất là trong lĩnh vực tài chính, chọn phương án trông có vẻ an toàn nhất: cấm dùng AI. Nhưng dữ liệu cho thấy lệnh cấm hiếm khi ngăn được hành vi. Theo Microsoft và LinkedIn Work Trend Index 2024, khảo sát 31.000 người lao động tại 31 quốc gia, 75% người lao động tri thức đã dùng AI trong công việc và 78% trong số đó tự mang công cụ AI của riêng mình vào công việc. Doanh nghiệp không cung cấp công cụ chính thức thì nhân viên vẫn dùng, chỉ là dùng ở nơi doanh nghiệp không nhìn thấy.
Đó là hiện tượng shadow AI, và cái giá của nó đã được đo đếm. Báo cáo Cost of a Data Breach 2025 của IBM ghi nhận 20% tổ chức tham gia nghiên cứu từng bị xâm phạm dữ liệu do sự cố liên quan đến shadow AI, và tổ chức có mức shadow AI cao chịu thêm trung bình khoảng 670.000 USD chi phí cho mỗi vụ vi phạm so với nhóm ít hoặc không có shadow AI. Trong các tổ chức gặp sự cố liên quan đến AI, 97% không có cơ chế kiểm soát truy cập AI phù hợp; 63% tổ chức bị xâm phạm chưa có hoặc vẫn đang xây dựng chính sách quản trị AI.
Trường hợp của Samsung năm 2023 là một ví dụ điển hình: sau khi phát hiện nhân viên đưa mã nguồn nhạy cảm lên ChatGPT, công ty đã cấm nhân viên dùng các công cụ AI tạo sinh như ChatGPT, Google Bard và Bing, vì dữ liệu đã gửi lên máy chủ bên ngoài rất khó thu hồi và xóa bỏ. Lệnh cấm khi đó là phản ứng sau sự cố, không phải một chiến lược.
Cách tiếp cận chín chắn hơn là chủ động. Thay vì lảng tránh để rồi AI vẫn được dùng ngoài tầm kiểm soát, doanh nghiệp cung cấp công cụ chính thức đủ tốt để nhân viên không cần tìm đường vòng, đi kèm quy chế, quy trình và cơ chế đo lường rõ ràng. Điểm cốt lõi không nằm ở việc AI thông minh đến đâu, mà ở việc sử dụng AI có đáng tin cậy, có kiểm soát, có bảo đảm an ninh và an toàn thông tin, và có truy vết được hay không.
Khung ứng dụng AI có kiểm soát trong phát triển phần mềm
Từ góc nhìn của một đơn vị phát triển phần mềm và tư vấn chuyển đổi số, chúng tôi đề xuất tiếp cận việc ứng dụng AI như một chương trình thay đổi có cấu trúc, gồm sáu lớp đi từ quy chế đến đo lường. Cấu hình cụ thể sẽ khác nhau giữa các doanh nghiệp, khách hàng và dự án, nhưng cả sáu lớp đều cần được trả lời rõ ràng.
1. Quy chế và chính sách sử dụng AI
Đây là văn bản nền tảng, quy định danh mục công cụ và mô hình được phép dùng; cách phân loại dữ liệu và loại dữ liệu nào được đưa vào AI ở môi trường nào; trách nhiệm giải trình, theo nguyên tắc kỹ sư commit code do AI hỗ trợ chịu trách nhiệm như với code tự viết; các vấn đề sở hữu trí tuệ và giấy phép mã nguồn; cùng cơ chế xử lý vi phạm. Thay vì tự xây dựng từ đầu, doanh nghiệp có thể tham chiếu ISO/IEC 42001:2023 về hệ thống quản lý AI và NIST AI Risk Management Framework. Đây cũng chính là năng lực “quan điểm AI rõ ràng” mà DORA đặt lên hàng đầu.
2. Tiêu chuẩn kỹ thuật
Quy chế cần được cụ thể hóa thành các tiêu chuẩn đo kiểm được. NIST SSDF (SP 800-218) là khung phát triển phần mềm an toàn nền tảng, áp dụng cho mọi dòng code dù do người hay AI viết; bản bổ sung SP 800-218A đưa thêm các thực hành dành riêng cho dự án phát triển mô hình và hệ thống AI tạo sinh. Khi sản phẩm tích hợp mô hình ngôn ngữ lớn như chatbot, trợ lý ảo hay agent, OWASP Top 10 for LLM Applications giúp nhận diện các rủi ro đặc thù như prompt injection, rò rỉ thông tin nhạy cảm hay trao quyền quá mức cho agent. Bên cạnh đó là các tiêu chuẩn nội bộ: coding convention, yêu cầu kiểm thử tối thiểu, danh mục thư viện được phép dùng và tiêu chí review dành cho code do AI hỗ trợ.
3. Quy trình AI-SDLC với các cổng kiểm soát
Thay vì coi “dùng AI” là một bước tách rời, AI được đưa vào từng khâu của vòng đời phát triển, và mỗi khâu có một cổng kiểm soát tương ứng. Công việc chỉ được chuyển sang khâu tiếp theo khi đạt các tiêu chí đã thống nhất.
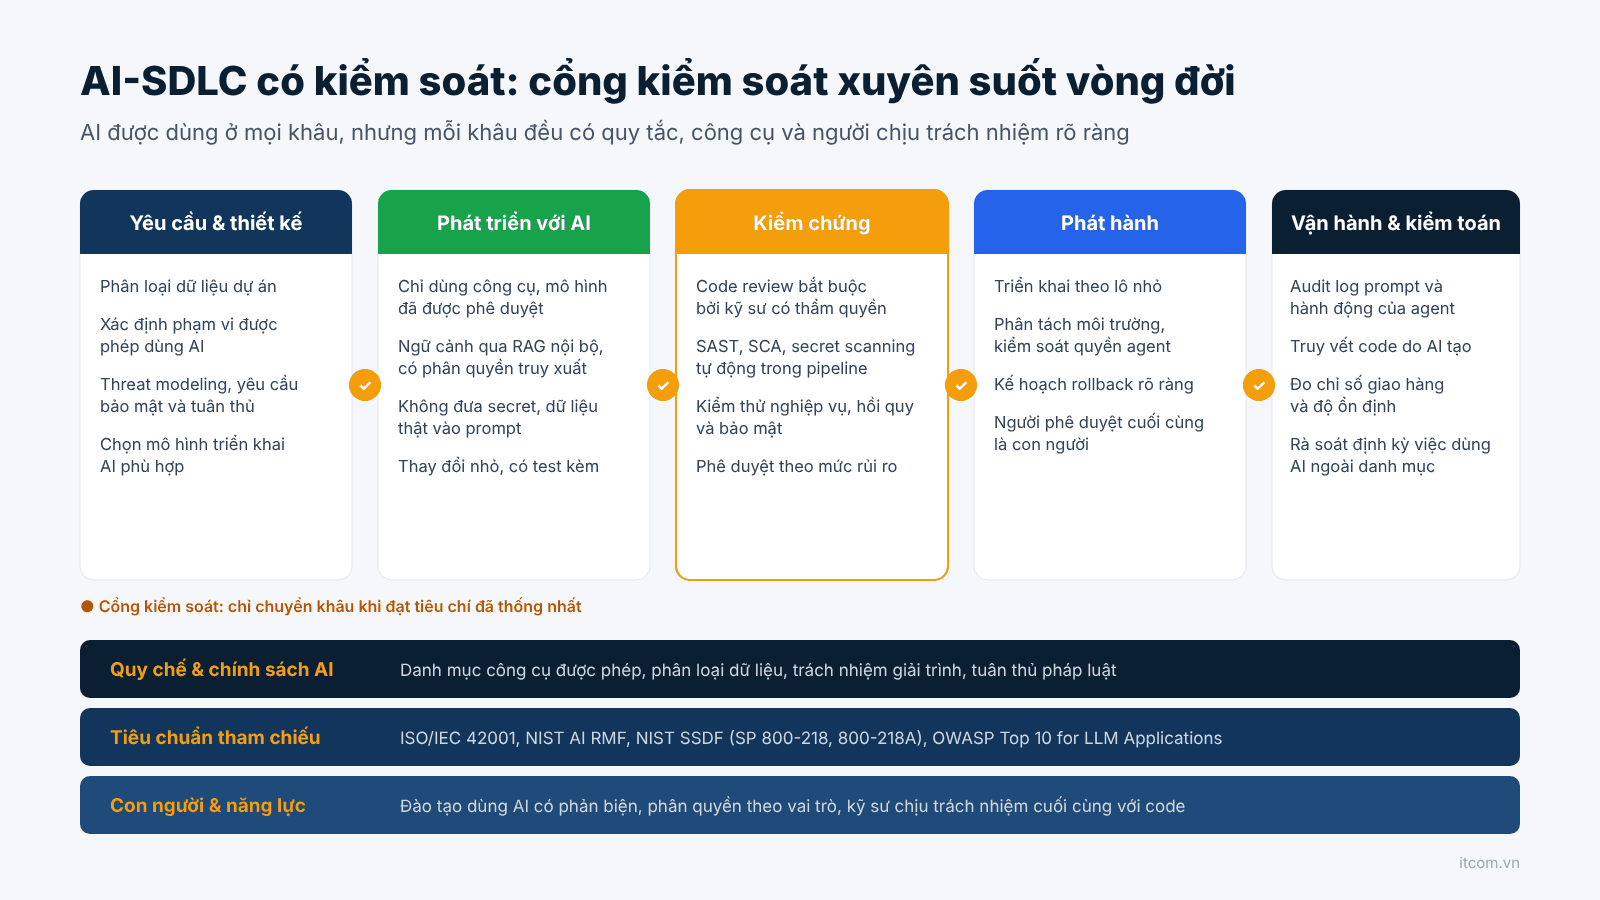
Ở khâu yêu cầu và thiết kế, dự án được phân loại dữ liệu và xác định rõ phạm vi được phép dùng AI. Ở khâu phát triển, kỹ sư chỉ dùng công cụ đã được phê duyệt, không đưa secret hay dữ liệu thật vào prompt, và mỗi thay đổi đi kèm test. Khâu kiểm chứng là nơi dữ liệu của Veracode trở nên đặc biệt quan trọng: review bởi kỹ sư có thẩm quyền, quét mã nguồn tĩnh (SAST), phân tích thành phần phần mềm (SCA) và quét secret tự động trong pipeline là bắt buộc, không phải tùy chọn. Với AI agent có khả năng tự thực thi, cần áp dụng nguyên tắc đặc quyền tối thiểu, tách biệt môi trường và không cho agent truy cập production. Quyết định phát hành cuối cùng luôn thuộc về con người.
4. Kiến trúc triển khai: chọn mô hình AI theo độ nhạy cảm dữ liệu
Không phải mọi dự án đều cần cùng một mức kiểm soát. Lựa chọn kiến trúc triển khai AI nên căn cứ vào độ nhạy cảm của dữ liệu, yêu cầu của khách hàng và nghĩa vụ tuân thủ.
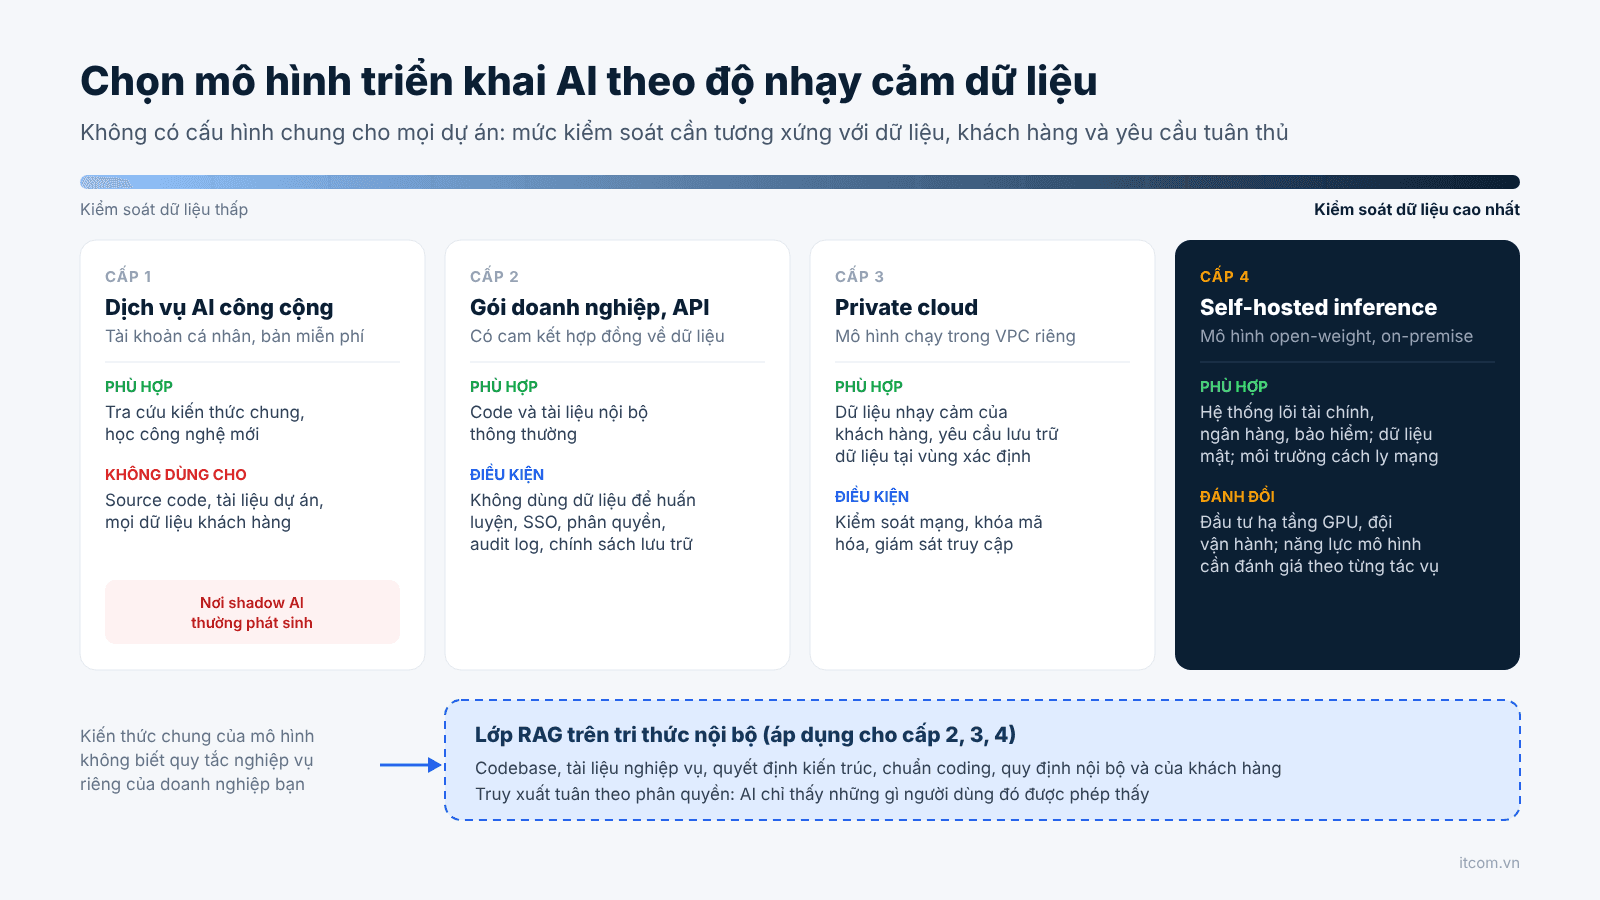
Dịch vụ AI công cộng bằng tài khoản cá nhân chỉ phù hợp để tra cứu kiến thức chung và không nên dùng cho bất kỳ code hay dữ liệu dự án nào. Gói doanh nghiệp hoặc API có cam kết hợp đồng về việc không dùng dữ liệu để huấn luyện, có SSO, phân quyền và audit log là lựa chọn cân bằng cho phần lớn code và tài liệu nội bộ thông thường. Khi dữ liệu nhạy cảm hơn hoặc khách hàng yêu cầu lưu trữ dữ liệu tại vùng xác định, mô hình có thể được triển khai trong private cloud dưới sự kiểm soát mạng và mã hóa của doanh nghiệp.
Với hệ thống lõi tài chính, ngân hàng, bảo hiểm, dữ liệu mật hoặc môi trường cách ly mạng, tự triển khai suy luận (self-hosted inference) trên hạ tầng của doanh nghiệp với các mô hình open-weight là phương án bảo đảm dữ liệu không rời khỏi hạ tầng. Đổi lại, doanh nghiệp phải đầu tư hạ tầng GPU, đội ngũ vận hành, quy trình cập nhật mô hình, và cần đánh giá năng lực mô hình trên chính các tác vụ của mình thay vì chỉ dựa vào benchmark công khai. Self-host vì vậy là lựa chọn “khi cần”, không phải mặc định cho mọi thứ. Một doanh nghiệp phần mềm hoàn toàn có thể vận hành song song nhiều cấp: dự án website dùng gói doanh nghiệp, trong khi dự án core banking cho khách hàng ngân hàng dùng mô hình tự triển khai theo đúng yêu cầu hợp đồng.
5. RAG: đưa tri thức của chính doanh nghiệp vào AI
Một mô hình AI, dù mạnh đến đâu, cũng chỉ có kiến thức chung từ dữ liệu huấn luyện. Nó không biết quy tắc tính phí của một sản phẩm bảo hiểm cụ thể, không biết quyết định kiến trúc mà nhóm đã chốt năm ngoái, cũng không biết chuẩn đặt tên trong codebase của bạn. Retrieval-Augmented Generation (RAG), kỹ thuật được Lewis và cộng sự công bố năm 2020, giải quyết bài toán này bằng cách truy xuất tài liệu liên quan từ kho tri thức nội bộ và đưa vào ngữ cảnh trước khi mô hình trả lời.
Trong phát triển phần mềm, kho tri thức đó gồm codebase, tài liệu đặc tả nghiệp vụ, hồ sơ quyết định kiến trúc, chuẩn coding và các quy định nội bộ cũng như của khách hàng. Có ba điều cần lưu ý khi triển khai. Thứ nhất, chất lượng câu trả lời phụ thuộc trực tiếp vào chất lượng tài liệu, điều trùng khớp với hai năng lực “hệ sinh thái dữ liệu lành mạnh” và “dữ liệu nội bộ sẵn sàng cho AI” trong mô hình của DORA. Thứ hai, truy xuất phải tôn trọng phân quyền: AI chỉ được thấy những gì người dùng đó được phép thấy, nếu không RAG sẽ trở thành một kênh rò rỉ dữ liệu mới. Thứ ba, RAG giảm đáng kể nhưng không loại bỏ hoàn toàn sai sót, nên output vẫn phải đi qua các cổng kiểm chứng như mọi output khác.
6. Đo lường, truy vết và kiểm toán
Lớp cuối cùng biến quy chế trên giấy thành thực tế vận hành. Doanh nghiệp cần lưu audit log về việc sử dụng AI và hành động của agent; đánh dấu các thay đổi có AI hỗ trợ trong lịch sử commit để truy vết; theo dõi các chỉ số giao hàng và độ ổn định theo khung DORA; và định kỳ rà soát việc sử dụng AI ngoài danh mục được phép. Theo IBM, trong số các tổ chức đã có chính sách quản trị AI, chỉ 34% thực hiện kiểm toán định kỳ đối với việc dùng AI chưa được phê duyệt, một khoảng trống mà nhiều doanh nghiệp đang để ngỏ.
Xuyên suốt cả sáu lớp là yếu tố con người: đào tạo kỹ sư dùng AI một cách có phản biện, phân quyền theo vai trò, và giữ nguyên tắc người chịu trách nhiệm cuối cùng với hệ thống luôn là con người.
Hàm ý chiến lược cho CIO, CTO và CEO
Đầu tư vào nền móng trước khi đầu tư vào công cụ
Mua license công cụ AI cho toàn bộ đội ngũ là bước dễ nhất và cũng ít tạo khác biệt nhất. Khác biệt nằm ở nền móng: quy chế AI, CI/CD ổn định, kiểm thử tự động đủ độ phủ, quản lý phiên bản chặt chẽ, nền tảng phát triển nội bộ tốt. Một tổ chức chưa có những thứ này sẽ chỉ dùng AI để tạo ra nhiều code chưa được kiểm chứng nhanh hơn.
Đo bằng kết quả, không đo bằng cảm nhận hay mức độ sử dụng
Bài học từ METR cho thấy cảm nhận của kỹ sư có thể lệch xa thực tế. DORA cũng cảnh báo về xu hướng “tokenmaxxing”, khi doanh nghiệp xếp hạng và khen thưởng theo lượng token AI tiêu thụ. Thước đo đúng là các chỉ số đầu ra của cả hệ thống: lead time từ yêu cầu đến khi phát hành, tần suất phát hành, tỷ lệ thay đổi gây lỗi, thời gian khôi phục khi có sự cố, và giá trị nghiệp vụ được giao. Hãy đo baseline trước khi triển khai để có cơ sở so sánh.
Đầu tư tương xứng cho năng lực kiểm chứng
Khi lượng code tăng, năng lực review, kiểm thử và bảo mật phải tăng theo, bằng cả con người lẫn tự động hóa. Đây là chi phí kiểm chứng không thể tránh và cần được đưa vào kế hoạch ngay từ đầu, thay vì phát hiện ra khi hàng đợi review đã ùn tắc hoặc khi sự cố đã xảy ra.
Đừng cắt đứt đường ống nhân tài trẻ
Cắt giảm tuyển dụng junior có thể giúp tiết kiệm chi phí ngắn hạn, nhưng sau vài năm, doanh nghiệp sẽ thiếu chính những kỹ sư senior có đủ kinh nghiệm để kiểm chứng output của AI. Cách làm bền vững hơn là thay đổi cách đào tạo: giao cho người mới những bài toán đòi hỏi tư duy và hiểu biết hệ thống, kèm cặp họ cách dùng AI có phản biện, thay vì để họ chỉ làm những việc AI đã làm tốt hơn.
Chấp nhận đường cong J và lập ngân sách cho giai đoạn học
Báo cáo ROI of AI-assisted Software Development năm 2026 của DORA mô tả lợi ích của AI theo đường cong J: hiệu quả thường chững lại trong giai đoạn đầu do chi phí học và kiểm chứng, trước khi tăng lên khi quy trình và nền tảng theo kịp. Lãnh đạo nên dự liệu giai đoạn này, thay vì kết luận vội vàng rằng AI “không hiệu quả” sau vài tháng thử nghiệm.
Lộ trình bốn giai đoạn ứng dụng AI trong phát triển phần mềm
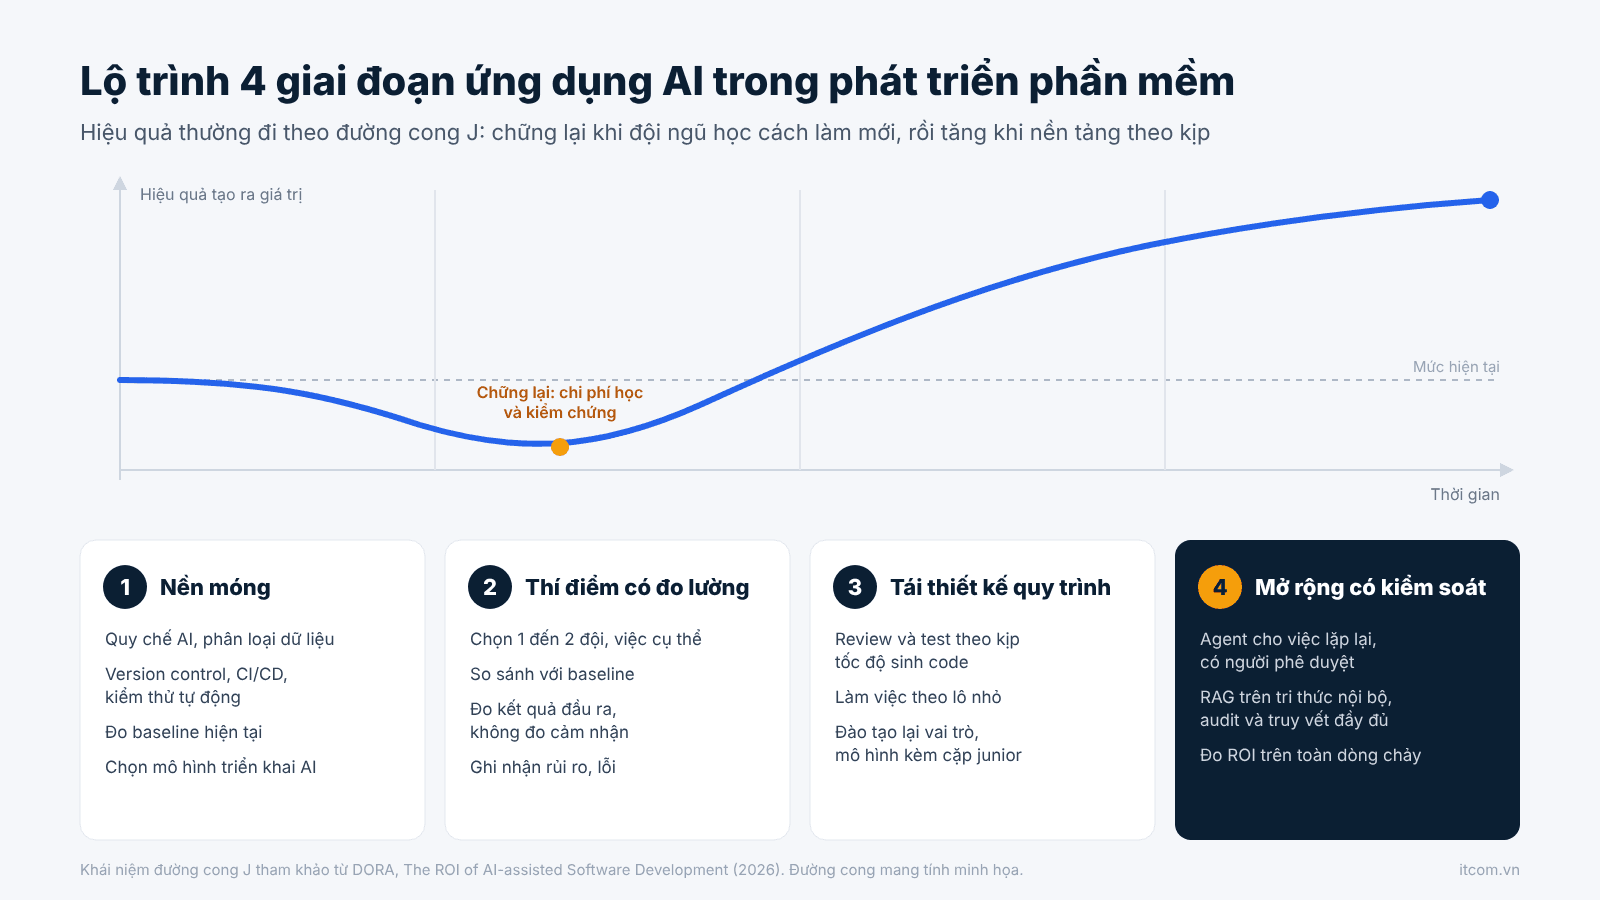
- Nền móng. Ban hành quy chế AI, phân loại dữ liệu và chọn mô hình triển khai phù hợp; chuẩn hóa version control, CI/CD và kiểm thử tự động; đo baseline năng lực phát triển hiện tại.
- Thí điểm có đo lường. Chọn một đến hai đội và một nhóm công việc cụ thể, so sánh với baseline bằng chỉ số đầu ra, ghi nhận các rủi ro và loại lỗi phát sinh.
- Tái thiết kế quy trình. Đưa các cổng kiểm soát vào AI-SDLC; điều chỉnh code review, kiểm thử và phát hành để theo kịp tốc độ sinh code; làm việc theo lô nhỏ; định nghĩa lại vai trò và mô hình kèm cặp kỹ sư trẻ.
- Mở rộng có kiểm soát. Đưa AI agent vào các công việc lặp lại với cơ chế phê duyệt của con người, xây dựng lớp RAG trên tri thức nội bộ, hoàn thiện audit và truy vết, đo ROI trên toàn bộ dòng chảy giá trị.
Câu hỏi thường gặp
AI có thay thế kỹ sư phần mềm không?
Dữ liệu hiện có chưa cho thấy tình trạng thay thế hàng loạt. AI đang thay đổi cơ cấu công việc: các tác vụ dễ hệ thống hóa được tự động hóa trước, còn nhu cầu về năng lực hiểu nghiệp vụ, thiết kế, kiểm chứng và chịu trách nhiệm hệ thống tăng lên. Áp lực rõ nhất đang rơi vào vị trí mới vào nghề.
Doanh nghiệp có nên giảm quy mô đội ngũ phát triển nhờ AI?
Chỉ nên cân nhắc khi đã đo được năng suất thực tế trên toàn dòng chảy, không dựa trên cảm nhận hay bản demo. Nhiều doanh nghiệp sẽ thấy lựa chọn hợp lý hơn là giữ đội ngũ và tăng khối lượng, chất lượng sản phẩm giao được, hoặc chuyển nguồn lực sang các khâu đang trở thành nút thắt như kiểm chứng và bảo mật.
Có nên cấm nhân viên dùng AI để bảo đảm an toàn thông tin?
Lệnh cấm hiếm khi hiệu quả vì nhân viên vẫn có thể dùng AI qua tài khoản cá nhân, tạo ra shadow AI khó kiểm soát hơn. Cách làm an toàn hơn là cung cấp công cụ chính thức phù hợp với mức độ nhạy cảm của dữ liệu, ban hành quy chế rõ ràng và giám sát việc tuân thủ.
Khi nào nên tự triển khai mô hình AI thay vì dùng dịch vụ?
Khi dữ liệu không được phép rời khỏi hạ tầng của doanh nghiệp, khi hợp đồng với khách hàng hoặc quy định chuyên ngành yêu cầu, hoặc khi hệ thống vận hành trong môi trường cách ly mạng. Với phần lớn công việc thông thường, gói doanh nghiệp có cam kết hợp đồng về dữ liệu thường là phương án cân bằng hơn về chi phí và năng lực mô hình.
Nên bắt đầu ứng dụng AI trong phát triển phần mềm từ đâu?
Bắt đầu từ quy chế AI, phân loại dữ liệu và nền móng kỹ thuật, đo baseline, sau đó thí điểm có kiểm soát ở một phạm vi nhỏ. Đầu tư công cụ nên đi sau, không đi trước.
Kết luận
AI trong phát triển phần mềm không phải phép màu cũng không phải trào lưu nhất thời. Đó là một bộ khuếch đại mạnh, làm thay đổi nơi tạo ra giá trị trong quy trình phát triển. Với các hệ thống lõi của doanh nghiệp, giá trị đó chỉ thành hiện thực khi AI được đặt trong một khuôn khổ chặt chẽ: có quy chế, có tiêu chuẩn, có cổng kiểm soát, có kiến trúc triển khai phù hợp và có đo lường. Doanh nghiệp hưởng lợi nhiều nhất sẽ không phải là doanh nghiệp dùng AI nhiều nhất, mà là doanh nghiệp nhìn được cả con voi và biết cách điều khiển nó.
Với 20 năm kinh nghiệm phát triển phần mềm và gần 10 năm tư vấn chuyển đổi số, ITCOM sẵn sàng đồng hành cùng doanh nghiệp trong việc đánh giá mức độ sẵn sàng, xây dựng quy chế và quy trình AI-SDLC, lựa chọn kiến trúc triển khai AI phù hợp với đặc thù dữ liệu và yêu cầu tuân thủ. Liên hệ với chúng tôi qua email [email protected] hoặc hotline 0966 318 336.
Tài liệu tham khảo
- Google Cloud, DORA: State of AI-assisted Software Development (2025)
- Google Cloud: Introducing DORA’s inaugural AI Capabilities Model (2025)
- DORA: The ROI of AI-assisted Software Development (2026)
- DORA Insights: Finding balance in the era of tokenmaxxing (2026)
- Stack Overflow Developer Survey 2025: AI
- METR: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (2025)
- METR: We are Changing our Developer Productivity Experiment Design (2026)
- Brynjolfsson, Chandar, Chen: Canaries in the Coal Mine? (Stanford Digital Economy Lab, bản cập nhật 08/2026)
- Veracode: 2025 GenAI Code Security Report
- Microsoft và LinkedIn: 2024 Work Trend Index
- IBM: Cost of a Data Breach Report 2025
- Bloomberg: Samsung Bans ChatGPT, Other Generative AI Use by Staff After Leak (2023)
- ISO/IEC 42001:2023, Artificial intelligence management system
- NIST AI Risk Management Framework
- NIST Secure Software Development Framework (SP 800-218)
- NIST SP 800-218A: Secure Software Development Practices for Generative AI and Dual-Use Foundation Models (2024)
- OWASP Top 10 for LLM Applications
- Lewis và cộng sự: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- Báo Chính phủ: Việt Nam chính thức có Luật Trí tuệ nhân tạo (2025)
- Bộ Công an: Luật Bảo vệ dữ liệu cá nhân chính thức có hiệu lực thi hành từ ngày 01/01/2026
- Thông tư 09/2020/TT-NHNN quy định về an toàn hệ thống thông tin trong hoạt động ngân hàng